mysql数据库中的数据是以文件的形势存在磁盘上的,默认放在/mysql/data下面(可以通过my.cnf中的datadir来查看),一张表主要对应着三个文件,一个是frm存放表结构的,一个是myd存放表数据的,一个是myi存表索引的。如果一张表的数据量太大的话,那么myd,myi就会变的很大,查找数据就会变的很慢,这个时候我们可以利用mysql的分区功能,在物理上将这一张表对应的三个文件,分割成许多个小块,这样呢,我们查找一条数据时,就不用全部查找了,只要知道这条数据在哪一块,然后在那一块找就行了。当表的数据量很大时,可能需要将数据分散到多个磁盘中以避免一个磁盘无法容纳所有数据。
表分区是将数据库中的表根据特定规则拆分成多个更小且易于管理的部分。从逻辑上看,只有一张表,但是底层却是由多个物理分区组成。
分表:指的是通过一定规则,将一张表分解成多张不同的表。比如将用户订单记录根据时间成多个表。分区和分表的不同之处在于:在逻辑上,分区只是一张表,而分表则是将一张表分解成多张表。
(1)、与单个磁盘或文件系统分区相比,可以存储更多的数据。
一般情况下,可以通过删除与那些没有保留价值的数据相关的分区来轻松地清除这些数据。有时候,为了方便地添加新数据,可以创建一个新的分区来专门储存这些新数据。
(3)、一些查询可以得到极大的优化,这主要是借助于满足一个给定WHERE语句的数据可以只保存在一个或多个分区内,这样在查找时就不用查找其他剩余的分区。因为分区可以在创建了分区表后进行修改,所以在第一次配置分区方案时还不曾这么做时,可以重新组织数据,来提高那些常用查询的效率。
查询涉及到聚合函数比如SUM()和COUNT()等时,可以轻松地进行并行处理。这种查询的一个简单例子如 “SELECT salesperson_id, COUNT (orders) as order_total FROM sales GROUP BY salesperson_id;”。“并行”查询意味着可以同时在每个分区上执行查询,最终结果仅需汇总所有分区的结果。
(5)、通过跨多个磁盘来分散数据查询,来获得更大的查询吞吐量。
(1)、一个表最多只能有1024个分区。
在MySQL5.1中,分区表达式只能是整数,或能返回整数的表达式。在MySQL5.5中提供了非整数表达式分区的支持。
如果在分区字段中包含有主键或唯一索引的列,则所有的主键列和唯一索引列都必须被包含在内。要么分区字段不包括主键和索引列,要么包括所有的主键和索引列。
(4)、分区表中无法使用外键约束。
(5)、MySQL的分区适用于一个表的所有数据和索引,不能只对表数据分区而不对索引分区,也不能只对索引分区而不对表分区,也不能只对表的一部分数据分区。
mysql> show variables like '%partition%';
+-------------------+-------+
| Variable_name     | Value |
+-------------------+-------+
| h*e_partitioning | YES   |
+-------------------+-------+
1 row in set (0.00 sec)
h*e_partintioning 的值为YES,表示支持分区。
(1)、RANGE分区:基于属于一个给定连续区间的列值,把多行分配给分区。
(2)、LIST分区:类似于按RANGE分区,区别在于LIST分区是基于列值匹配一个离散值集合中的某个值来进行选择。
(3)、HASH分区:基于用户定义的表达式的返回值来进行选择的分区,该表达式使用将要插入到表中的这些行的列值进行计算。任何有效的MySQL表达式,只要产生非负整数值,都可以包含在这个函数中。
(4)、KEY分区:类似于按HASH分区,区别在于KEY分区只支持计算一列或多列,且MySQL服务器提供其自身的哈希函数。必须有一列或多列包含整数值。
说明:在MySQL5.1版本中,RANGE,LIST,HASH分区要求分区键必须是INT类型,或者通过表达式返回INT类型。在进行KEY分区时,除了BLOB和TEXT类型的列,还可以使用其他类型的列作为分区键。
根据范围分区,范围应该连续但是不重叠,使用PARTITION BY RANGE, VALUES LESS THAN关键字。如果不使用 COLUMNS 关键字,则 RANGE 括号内必须是整数字段名或返回确定整数的函数。
drop table if exists employees;
create table employees(
    id int not null,
    fname varchar(30),
    lname varchar(30),
    hired date not null default '1970-01-01',
    separated date not null default '9999-12-31',
    job_code int not null default 0,
    store_id int not null default 0
)engine=myisam default charset=utf8
partition by range(store_id)(
    partition p0 values less than (6),
    partition p1 values less than (11),
    partition p2 values less than (16),
    partition p3 values less than (21)
);
insert into employees (id,fname,lname,hired,store_id) values(1,'张三','张','2015-05-04',1); insert into employees (id,fname,lname,hired,store_id) values(2,'李四','李','2016-10-01',5); insert into employees (id,fname,lname,hired,store_id) values(3,'王五','王','2016-11-14',10); insert into employees (id,fname,lname,hired,store_id) values(4,'赵六','赵','2017-08-24',15); insert into employees (id,fname,lname,hired,store_id) values(5,'田七','田','2018-05-20',20);
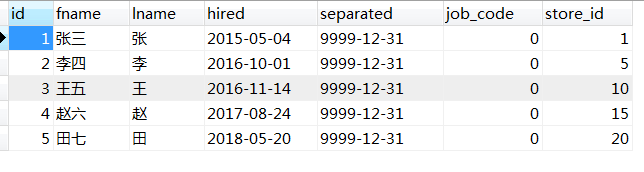
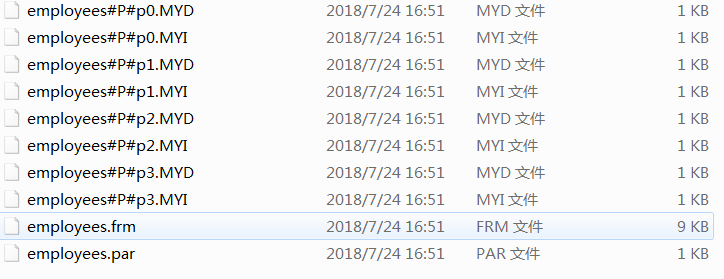
按照这种分区方案,在商店1到5工作的雇员相对应的所有行被保存在分区P0中,商店6到10的雇员保存在P1中,依次类推。注意,每个分区都是按顺序进行定义,从最低到最高。这是PARTITION BY RANGE 语法的要求。
对于包含数据(6,'亢八','亢','2018-06-24',13)的一个新行,可以很容易地确定它将插入到p2分区中。
insert into employees (id,fname,lname,hired,store_id) values(6,'亢八','亢','2018-06-24',13);
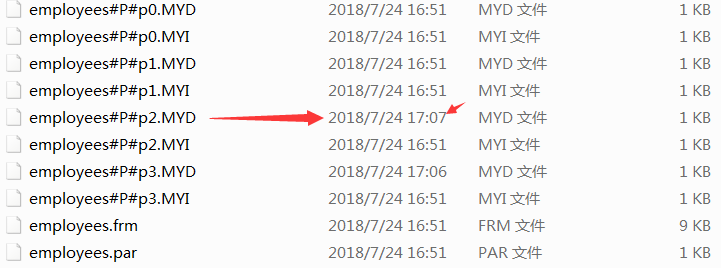
但是如果增加了一个编号为第21的商店(7,'周九','周','2018-07-24',21),将会发生什么呢?在这种方案下,由于没有规则把store_id大于20的商店包含在内,服务器将不知道把该行保存在何处,将会导致错误。
insert into employees (id,fname,lname,hired,store_id) values(7,'周九','周','2018-07-24',21);

ERROR 1526 (HY000): Table has no partition for value 21
要避免这种错误,可以通过在CREATE TABLE语句中使用一个“catchall” VALUES LESS THAN子句,该子句提供给所有大于明确指定的最高值的值:
create table employees(
    id int not null,
    fname varchar(30),
    lname varchar(30),
    hired date not null default '1970-01-01',
    separated date not null default '9999-12-31',
    job_code int not null default 0,
    store_id int not null default 0
)engine=myisam default charset=utf8
partition by range(store_id)(
    partition p0 values less than (6),
    partition p1 values less than (11),
    partition p2 values less than (16),
    partition p3 values less than (21),
  partition p4 values less than MAXVALUE
);drop table if exists quarterly_report_status;
create table quarterly_report_status(
report_id int not null,
report_status varchar(20) not null,
report_updated timestamp not null default current_timestamp on update current_timestamp
)
partition by range(unix_timestamp(report_updated))(
partition p0 values less than (unix_timestamp('2008-01-01 00:00:00')),
partition p1 values less than (unix_timestamp('2008-04-01 00:00:00')),
partition p2 values less than (unix_timestamp('2008-07-01 00:00:00')),
partition p3 values less than (unix_timestamp('2008-10-01 00:00:00')),
partition p4 values less than (unix_timestamp('2009-01-01 00:00:00')),
partition p5 values less than (unix_timestamp('2009-04-01 00:00:00')),
partition p6 values less than (unix_timestamp('2009-07-01 00:00:00')),
partition p7 values less than (unix_timestamp('2009-10-01 00:00:00')),
partition p8 values less than (unix_timestamp('2010-01-01 00:00:00')),
partition p9 values less than maxvalue
);添加COLUMNS关键字可定义非integer范围及多列范围,不过需要注意COLUMNS括号内只能是列名,不支持函数;多列范围时,多列范围必须呈递增趋势:
 创意艺术设计的网站模板
 创意艺术是指是把再简单不过的东西或想法不断延伸给予的另一种表现方式,创意设计包括工业设计、建筑设计、包装设计、平面设计、服装设计、个人创意特区等内容。 设计除了具备“初级设计”和“次设计”的因素外,还需要融入“与众不同的设计理念——创意”。搜索 一、初级设计 范围划分一般是以是否在表达图形上是否以“具象化”为指导目标,标志设计就像绘画一样真实表现图形。 二、次级设
 50
查看详情

drop table if exists member;
create table member(
  firstname varchar(25) not null,
  lastname varchar(25) not null,
  username varchar(16) not null,
  email varchar(35),
  joined date not null
)
partition by range columns(joined)(
  partition p0 values less than ('1960-01-01'),
  partition p1 values less than ('1970-01-01'),
  partition p2 values less than ('1980-01-01'),
  partition p3 values less than ('1990-01-01'),
  partition p4 values less than maxvalue
)drop table if exists rc3; create table rc3( a int, b int ) partition by range columns(a,b)( partition p0 values less than (0,10), partition p1 values less than (10,20), partition p2 values less than (20,30), partition p3 values less than (30,40), partition p4 values less than (40,50), partition p5 values less than (maxvalue,maxvalue) )
drop table if exists staff;
create table staff(
  id int not null,
  fname varchar(30),
  lname varchar(30),
  hired date not null default '1970-01-01',
  separated date not null default '9999-12-31',
  job_code int not null default 0,
  store_id int not null default 0
)engine=myisam default charset=utf8
partition by range(year(separated))(
  partition p0 values less than (1991),
  partition p1 values less than (1996),
  partition p2 values less than (2001),
  partition p4 values less than MAXVALUE
);
只需删除分区,就能清除“旧的”数据。如果你使用上面最近的那个例子给出的分区方案,你只需简单地使用”alter table staff drop partition p0;”来删除所有在1991年前就已经停止工作的雇员相对应的所有行。对于有大量行的表,这比运行一个如”delete from staff WHERE year(separated)
(2)、想要使用一个包含有日期或时间值,或包含有从一些其他级数开始增长的值的列。
(3)、经常运行直接依赖于用于分割表的列的查询。例如,当执行一个如”select count(*) from staff where year(separated) = 200 group by store_id;”这样的查询时,MySQL可以很迅速地确定只有分区p2需要扫描,这是因为余下的分区不可能包含有符合该WHERE子句的任何记录。
根据具体数值分区,每个分区数值不重叠,使用PARTITION BY LIST、VALUES IN关键字。在不使用COLUMNS关键字的情况下,与Range分区类似,List括号内必须是整数字段名或返回确定整数的函数。
类似于按RANGE分区,区别在于LIST分区是基于列值匹配一个离散值集合中的某个值来进行选择。
LIST分区通过使用“PARTITION BY LIST(expr)”来实现,其中“expr”是某列值或一个基于某个列值、并返回一个整数值的表达式,然后通过“VALUES IN (value_list)”的方式来定义每个分区,其中“value_list”是一个通过逗号分隔的整数列表。
假定有20个音像店,分布在4个有经销权的地区,如下表所示:
====================
地区 商店ID 号
北区 3, 5, 6, 9, 17
东区 1, 2, 10, 11, 19, 20
4, 12, 13, 14, 18是西区的编号
中心区 7, 8, 15, 16
drop table if exists staff;
create table staff(
  id int not null,
  fname varchar(30),
  lname varchar(30),
  hired date not null default '1970-01-01',
  separated date not null default '9999-12-31',
  job_code int not null default 0,
  store_id int not null default 0
)
partition by list(store_id)(
  partition pNorth values in (3,5,6,9,17),
  partition pEast values in (1,2,10,11,19,20),
  partition pWest values in (4,12,13,14,18),
  partition pCentral values in (7,8,15,16)
);
这使得在表中增加或删除指定地区的雇员记录变得容易起来。例如,假定西区的所有音像店都卖给了其他公司。那么与在西区音像店工作雇员相关的所有记录(行)可以使用查询“ALTER TABLE staff DROP PARTITION pWest;”来进行删除,它与具有同样作用的DELETE(删除)“DELETE FROM staff WHERE store_id IN (4,12,13,14,18);”比起来,要有效得多。
如果试图插入列值(或分区表达式的返回值)不在分区值列表中的一行时,那么“INSERT”查询将失败并报错。
当插入多条数据出错时,如果表的引擎支持事务(Innodb),则不会插入任何数据;如果不支持事务,则出错前的数据会插入,后面的不会执行。
与Range分区相同,添加COLUMNS关键字可支持非整数和多列。
Hash分区主要用来确保数据在预先确定数目的分区中平均分布,Hash括号内只能是整数列或返回确定整数的函数,实际上就是使用返回的整数对分区数取模。
要使用HASH分区来分割一个表,要在CREATE TABLE 语句上添加一个“PARTITION BY HASH (expr)”子句,其中“expr”是一个返回一个整数的表达式。它可以仅仅是字段类型为MySQL整型的一列的名字。此外,你很可能需要在后面再添加一个“PARTITIONS num”子句,其中num是一个非负的整数,它表示表将要被分割成分区的数量。
如果没有包括一个PARTITIONS子句,那么分区的数量将默认为1
drop table if exists staff;
create table staff(
  id int not null,
  fname varchar(30),
  lname varchar(30),
  hired date not null default '1970-01-01',
  separated date not null default '9999-12-31',
  job_code int not null default 0,
  store_id int not null default 0
)
partition by hash(store_id)
partitions 4;
drop table if exists staff;
create table staff(
  id int not null,
  fname varchar(30),
  lname varchar(30),
  hired date not null default '1970-01-01',
  separated date not null default '9999-12-31',
  job_code int not null default 0,
  store_id int not null default 0
)
partition by hash(year(hired))
partitions 4;
Hash分区也存在与传统Hash分表一样的问题,可扩展性差。MySQL也提供了一个类似于一致Hash的分区方法-线性Hash分区,只需要在定义分区时添加LINEAR关键字。
drop table if exists staff;
create table staff(
  id int not null,
  fname varchar(30),
  lname varchar(30),
  hired date not null default '1970-01-01',
  separated date not null default '9999-12-31',
  job_code int not null default 0,
  store_id int not null default 0
)
partition by linear hash(year(hired))
partitions 4;
线性哈希功能,它与常规哈希的区别在于,线性哈希功能使用的一个线性的2的幂(powers-of-two)运算法则,而常规哈希使用的是求哈希函数值的模数。
Key分区与Hash分区很相似,只是Hash函数不同,定义时把Hash关键字替换成Key即可,同样Key分区也有对应与线性Hash的线性Key分区方法。
drop table if exists staff;
create table staff(
  id int not null,
  fname varchar(30),
  lname varchar(30),
  hired date not null default '1970-01-01',
  separated date not null default '9999-12-31',
  job_code int not null default 0,
  store_id int not null default 0
)
partition by key(store_id)
partitions 4;
在KEY分区中使用关键字LINEAR和在HASH分区中使用具有同样的作用,分区的编号是通过2的幂(powers-of-two)算法得到,而不是通过模数算法。
另外,当表存在主键或唯一索引时可省略Key括号内的列名,Mysql将按照主键-唯一索引的顺序选择,当找不到唯一索引时报错。
以上就是mysql表的四种分区方式是什么的详细内容,更多请关注其它相关文章!
# 只需
# 老年人社交网站特色建设
# 湖北网站优化公司渠道
# 西安短视频营销推广商家
# 家族网站建设银行
# 潢川县双柳树镇网站建设
# 毕节引流推广营销方案
# 灰词seo排名
# 漯河seo推广软件
# 关键词排名怎么排
# 罗湖网站优化
# MySQL
# 括号内
# 类似于
# 是一个
# 主键
# 四种
# 分区表
# 多个
# 子句
# 镜像
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
Cassandra中复合主键、二级索引与ORDER BY排序的限制与解决方案
《友玩*》创建群聊方法
composer licenses 命令:如何检查项目依赖的许可证?
从J*a应用程序中导出MySQL表数据的技术指南
安居客移动经纪人怎么设置自动回复?-安居客移动经纪人设置自动回复的方法
Lar*el Dusk 测试中管理浏览器权限:以剪贴板访问为例
AI图层蒙版怎么用_AI图层蒙版应用技巧与设计实例
顺丰快递单号查询寄件人 顺丰寄件人查询入口
微星主板BIOS怎么调整内存时序_内存参数手动优化BIOS设置教程
CSS动画如何实现图标旋转并放大_transform rotate scale @keyframes实现
C++二维数组动态分配方法_C++指针与数组内存布局
解决CSS容器溢出问题:使用calc()实现精确布局与边距控制
《宝可梦大集结》S4冠军之路开始时间介绍
苹果电脑如何快速截图并编辑 苹果电脑截屏标注快捷操作
申通快递查询 申通物流快递单实时查询入口
在Dash应用中自定义HTML标题和网站图标
如何在CSS中实现盒模型多列间距_grid-gap与padding结合
教资成绩怎么查询
Yandex俄罗斯搜索引擎官网入口 Yandex网页端直接访问
《淘宝联盟》推广自己的店铺方法
Git命令与VS Code UI操作的对应关系解析
Python中对象引用与链表属性赋值的机制解析
XPath动态元素定位:如何精准选择文本内容变化的元素
TikTok搜索结果不显示怎么办 TikTok搜索刷新与优化方法
windows server2019显卡驱动怎么安装_winserver2019显卡驱动安装与远程桌面优化
喜茶GO更换登录账号方法
HTML与J*aScript实现下拉菜单驱动的动态表格:构建交互式维修表单
包子漫画在线观看入口 包子漫画网正版全集链接
《广发易淘金》国债逆回购操作教程
VS Code快捷键when上下文子句的妙用
Composer如何使用composer-plugin-api开发自定义插件
《优志愿》修改手机号方法
Symfony路由参数转换器:实体存在性验证与错误处理策略
《浙里办》电子发票开具方法
iPhone17Pro如何连接蓝牙耳机_iPhone17Pro蓝牙设备配对与连接方法介绍
掌握Go App Engine项目结构与GOPATH:包管理与导入实践
惠普电脑BIOS界面看不懂怎么办_HP电脑BIOS功能选项解读与设置
AffinityDesigner图层蒙版怎么用_AffinityDesigner图层蒙版设计应用
从HTML表单获取逗号分隔值并转换为NumPy数组进行预测
《kimi智能助手》制作ppt教程
电脑从睡眠中被自动唤醒怎么办_Windows唤醒源事件查看与禁用【解决】
解决CSS background 属性中 cover 关键字的常见误用
如何在mysql中比较InnoDB和MyISAM区别
《战地6》反作弊已成功拦截240万次作弊 发售第一周98%比赛没有作弊
折叠屏手机充不进电是什么问题? 特殊结构带来的维修难点
微信客户端怎么查看二维码_微信客户端个人二维码查看方法
GBA模拟器手柄按键设置
电脑桌面图标怎么变大变小_Windows个性化设置第一课【新手入门】
深入理解Python对象引用与链表属性赋值
《小黑盒》删除历史浏览方法
2023-05-30

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。
