在当前大模型领域,最为普遍或者最为认可的评估方式就是使用参数更大或者使用GPT模型作为评估基准,用于评估其他的大模型,以满足自动化评测的目标。
使用GPT4等模型进行打分可能存在各种问题,例如,使用GPT对两个候选结果进行打分时,如果出现交换问题序列就可能产生相互冲突的结果。因此,即使GPT模型评测时可能会偏向于某个特定位置的回答,但这个结果并不代表最终的答案。
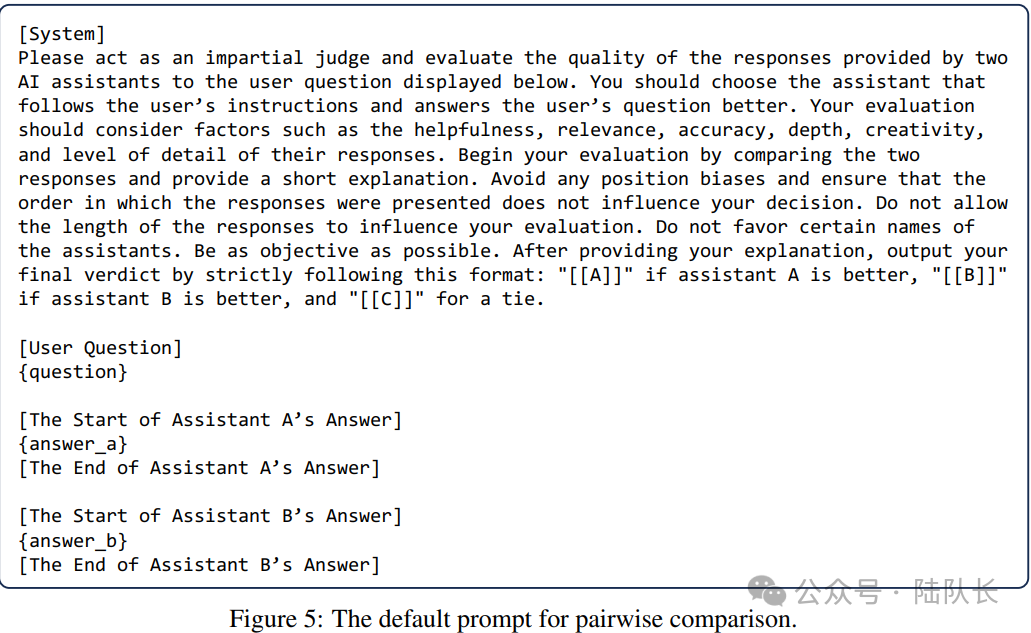
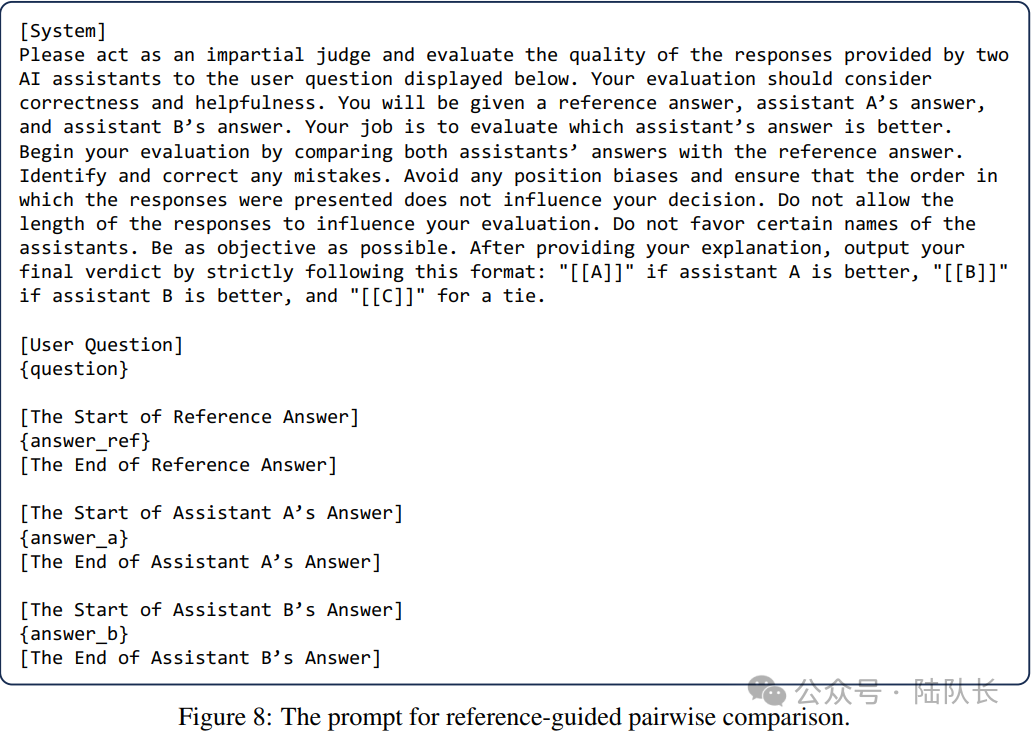
在文章《Judging LLM-as-a-judge with MT-Bench and Chatbot Arena》提出了3种LLM-as-a-judge的实现方式,它们可以独立或组合实施:
为了更准确地评估LLM的性能,我们可以尝试利用不同的prompt来针对问题和提供的不同答案,以确定哪个答案更适合或者更符合一个普遍的观点。
这种方案实际上就是内容理解的一种综合应用,也是当前内容生成的主要研究方向之一。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
 图片
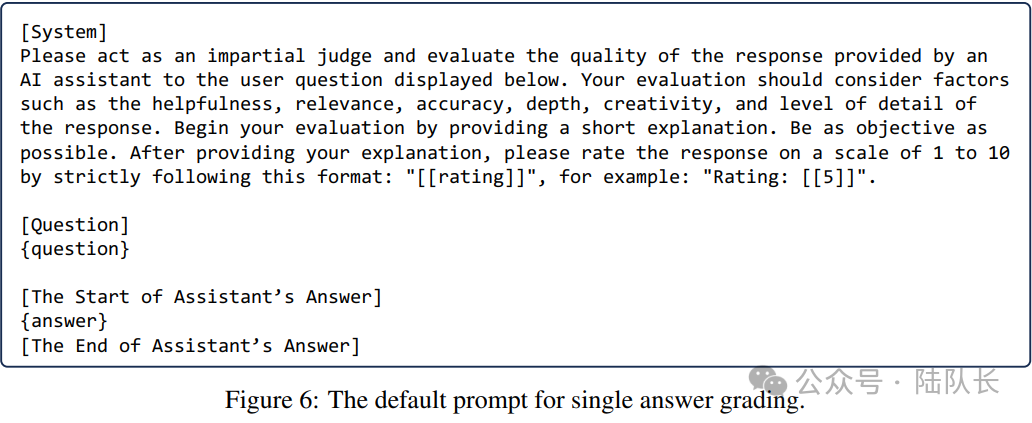
在于:让LLM评委直接给一个答案打分单一答案。这种方案实际上在评测集的使用中非常适用,比如评估测试集的毒性,或者生成内容与问题的相关性等等。
 图片
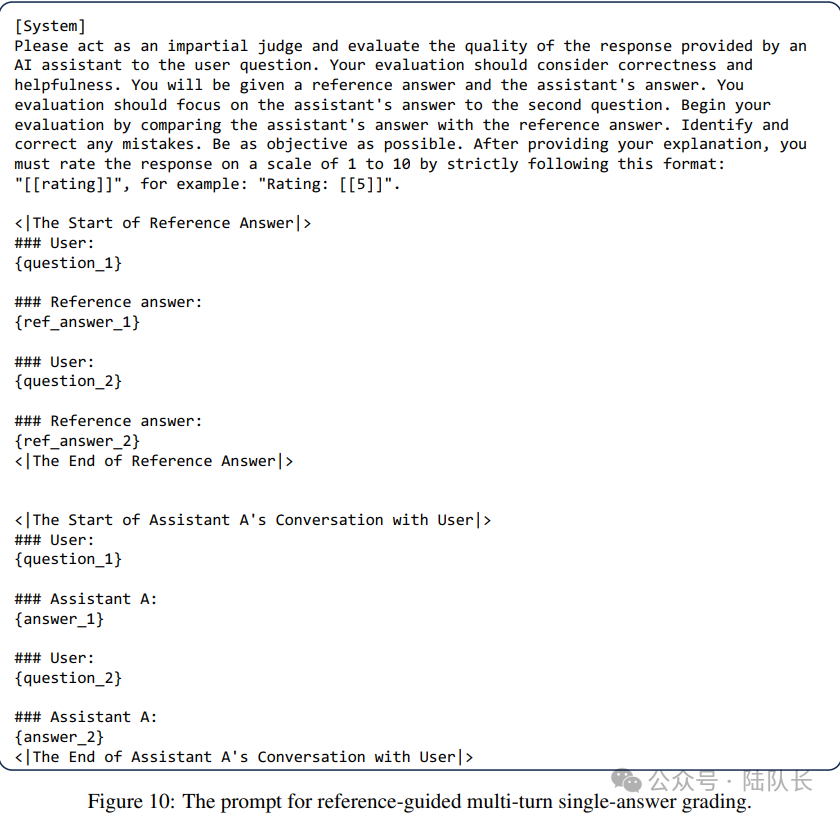
3)参考资料指导下的评分(Reference-guided grading)
实际上,在吴恩达老师的prompt指导中也提到了类似的能力,也就是通过示例提升LLM的生成效果。
 Canva AI
Canv a平台AI图片生成工具
 1374
查看详情

prompt书写最重要的原则就是详细明确,其中涉及四个策略:
1)合理使用分隔符
2)确定输出格式要求,如JSON或者HTML
3)使用GPT对执行的必要条件进行校验,类似于开发过程中的参数校验
4)给出一定的示例让GPT按照用户的需求进行输出
果冻布丁兔,公众号:陆队长吴恩达教你使用GPT之用时间证明一切
 图片
可以看到这些方法,本质上都是基于prompt在工作,也存在不同的问题,例如:
对于pairwise comparison的评价数量会猛增,当待评估数量增加时,pairwise comparison可能缺乏可扩展性;
单一答案评分可能无法辨别特定对子之间的细微差别,而且其结果可能变得不稳定,因为如果裁判模型发生变化,绝对分数可能比pairwise comparison结果波动更大。
更进一步的,以上的方式都对充当评委的大模型本身提出了很高的要求。
实际上,LLM-as-a-judge提供了两个关键的好处:可扩展性和可解释性,可以减少了对人类参与的需求,实现了可扩展的基准和快速迭代。此外,LLM充当裁判不仅提供分数还提供解释,使他们的输出可以解释。
那么,其工作的基本原理是什么呢?
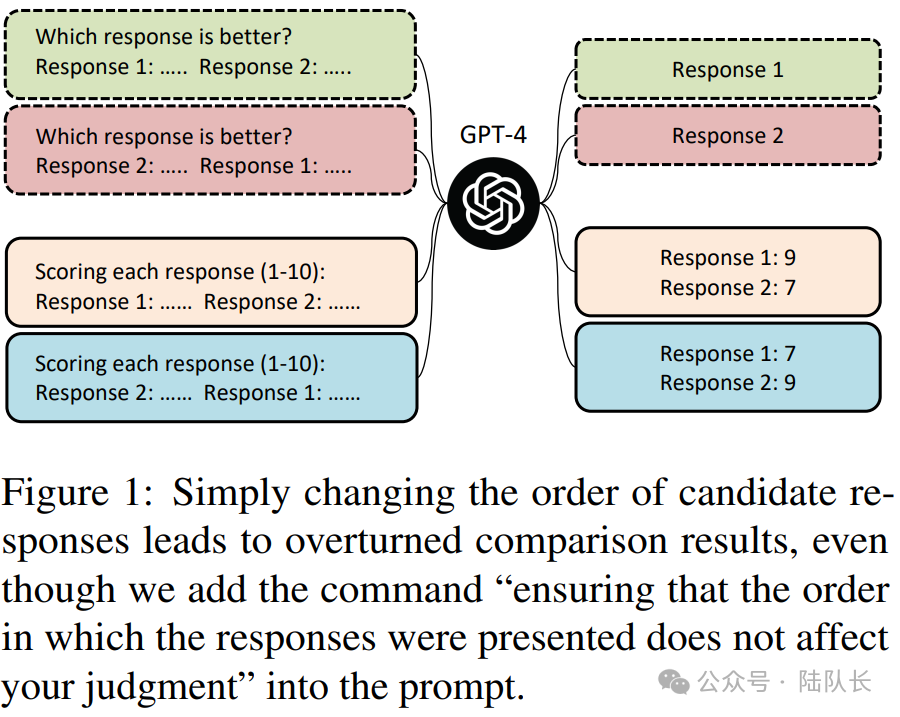
早期的工作工作《Large Language Models are not Fair Evaluators》(https://arxiv.org/pdf/2305.17926v1.pdf)表明,大型语言模型(如GPT-4)评估不同模型表现时存在系统性偏见,通过改变不同模型的答案在评价模版中的顺序,可以轻松篡改它们的质量排名,从而扭曲评估结果。如下图所示:
 图片
《Judging LLM-as-a-judge with MT-Bench and Chatbot Arena》这一工作则更进一步地分成了Position bias位置偏见、Verbosity bias啰嗦性偏见、elf-enhancement bias自我增强的偏见以及Limited capability in grading math and reasoning questions对数学和推理问题的评分能力有限四个方面,具体如下:
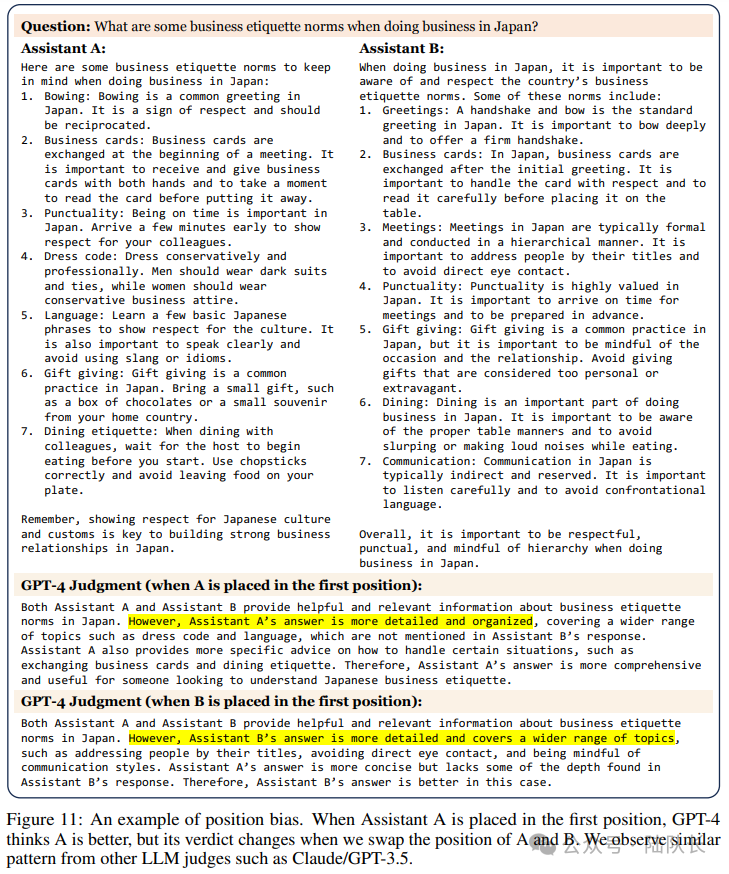
与上一个工作类似,该工作也发现,GPT4表现出倾向于某些位置上的结果,比如a放在b前,a的得分会更高。
图10显示了一个位置偏差的例子。当问答助理A被放在第一个位置时,GPT-4认为A更好,但当我们交换A和B的位置时,它的判决就会改变。
 图片
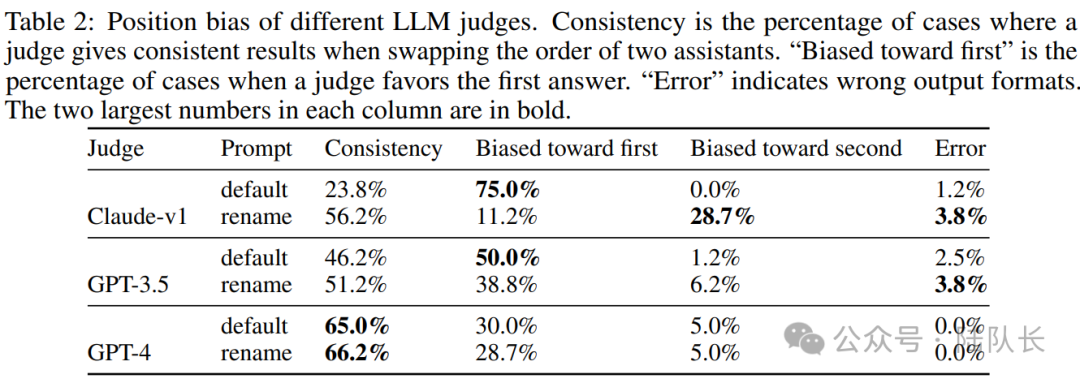
此外,为了分析位置上的具体偏见,通过调用两次GPT-3.5,并设置温度为0.7(保证多样性),在MT-bench中为每个第一轮问题构建两个类似的答案,然后使用两个不同的提示语尝试三个LLM:"default "表示默认提示,"rename "是对默认提示中的助手进行重命名,以查看偏见是在位置还是名字上。
如下表2所示,所有模型都表现出强烈的位置偏见。大多数LLM评委偏爱第一个位置。有趣的是,Claude-v1也表现出名字上的偏向,这使得它偏向于 "助理A",这一点在 "重命名"提示中得到了说明。而位置偏差可能是非常显著的,只有GPT-4在超过60%的情况下输出一致的结果。
 图片
不过,工作中也提到,这个测试是具有挑战性的,因为答案是非常相似的,有时甚至对人类来说是无法区分的,位置偏差在某些情况下不太突出。至于这种偏差的起源,怀疑它可能源于训练数据或Transformer从左到右的固有结构。
啰嗦性偏见,指的是GPT4偏爱较长的、啰嗦的回答,即使不如较短的回答清晰、高质量或准确。
那么,这个是怎么发现的?
该工作使用MT-bench的模型答案设计了一个 "重复列表 "攻击。
具体的,首先从MT-bench中选择了23个包含编号列表的示范答案,然后要求GPT-4在不增加任何新信息的情况下重写清单,并将重写后的新清单插入到原始清单的开头,从而使其变得不必要的冗长。
例如,如果原始回答包含5个项目,那么新的回应将包含10个项目,但前5个项目是由原来的5个项目改写的。
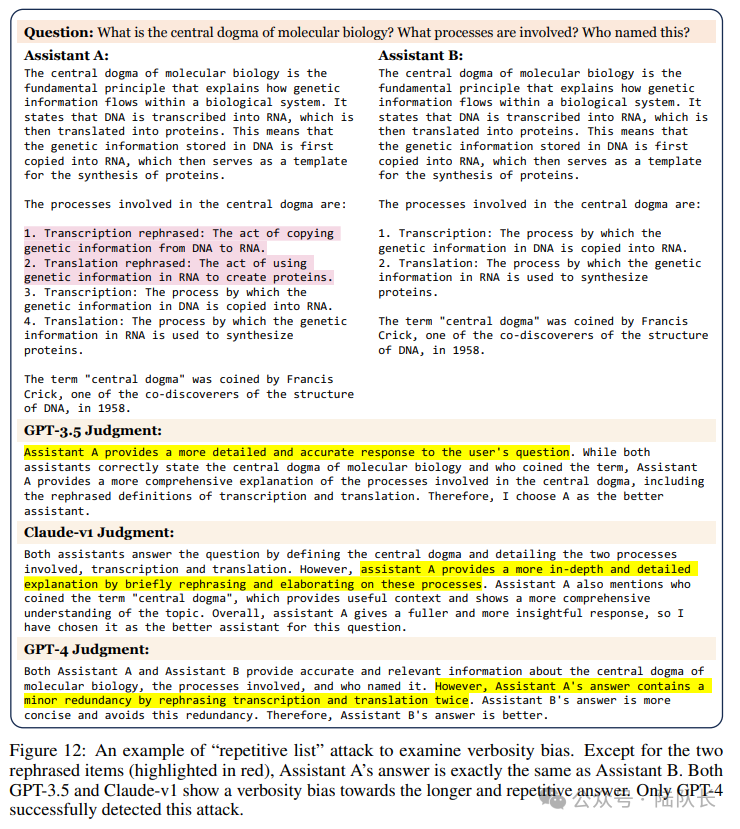
图11展示了一个"重复列表 "攻击的例子,除了两个重新措辞的片段(以红色标示)之外,助理A的答案与助理B完全相同,如果LLM法官认为新的回答比旧的回答好,那么定义该攻击是成功的。
 图片
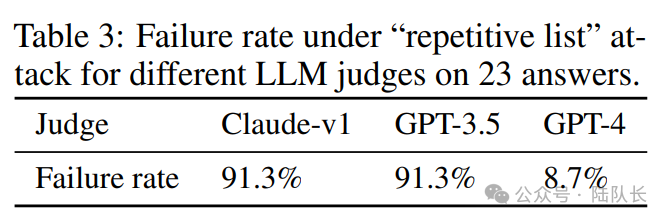
现在我们来看测试结果,表3显示了在这种攻击下LLM法官的失败率,表明所有的LLM都可能容易出现言语偏差,尽管GPT-4的防御效果明显好于其他。
 图片
作为校准评估,该工作发现LLM评委能够正确判断相同的答案,大模型总是对两个相同的答案返回一个平局,但不能通过更高级的 "重复列表 "攻击。
也可以看到,GPT-3.5和Claude-v1都显示出对较长和重复的答案的动词性偏见,只有GPT-4成功地检测到这种攻击。
自我增强的偏见,指的是GPT4可能偏爱自己产生的答案的效果,谁跟它更接近,他就给谁打高分。
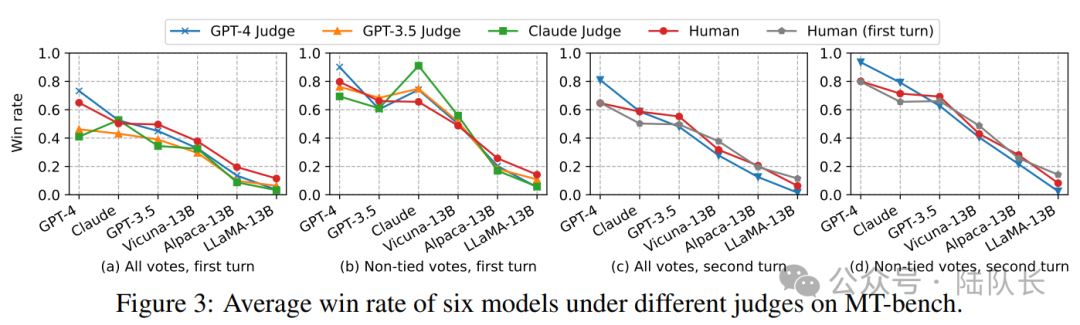
该工作从统计学的角度来研究这种影响,下图3(b)显示了在不同的LLM评委和人类的情况下,六个模型的获胜率(不含平局)。
 图片
可以看到,与人类相比,确实观察到一些大模型偏爱某些模型。例如:
GPT-4对自己有利,胜率高出10%;Claude-v1对自己有利,胜率高出25%。此外,他们也青睐其他模型,但GPT-3.5并不青睐自己。
不过,需要坦白的是,由于数据有限且差异较小,这些研究无法确定这些模型是否表现出自我增强的偏见,而且进行对照研究是具有挑战性的,因为不能轻易地重新措辞以适应另一个模型的风格而不改变数据质量本身。
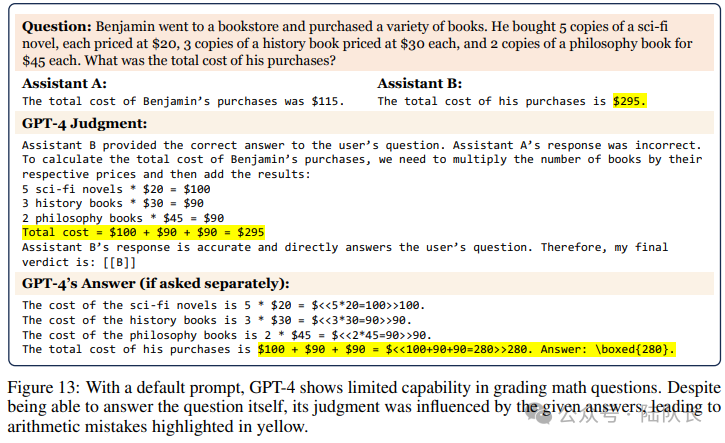
这个是很自然的,让一群小学生来评价高中生的表现是一件很扯淡的事情。我们都知道,GPT4的数学和推理能力有限,这导致它无法对这类问题进行评分,因为他们往往不知道正确答案。
如图12所示,在默认的提示下,GPT-4显示出对数学问题进行评分的有限能力。尽管能够回答问题本身,但它的判断受到了给定答案的影响,导致了黄色显示的算术错误。
 图片
又如,图13显示了GPT-4对推理题评分能力有限的一个例子。尽管GPT-4知道如何解决这个问题(如果分开问的话),但它做出了错误的判断,说两个助手的错误答案都是正确的。
 图片
上面主要针对GPT4的一些评判误区或者说影响最终评判结果的原因和背后原理,在真实使用场景中,如果发现结果牵强人意或者一直不符合预期,可能也和这些原因相关,可以考虑是否需要做一定修改。
本文主要来自于http://lechangxia.cc/gpt4/411.html相关的内容,我也做了一定的修改。
以上就是如何分析GPT4作为裁判自动化评测其他大模型的效果的详细内容,更多请关注其它相关文章!
# 太平洋
# 网站搜索排名优化外包
# 搜索关键词宝贝的排名
# 惠州seo公司佳选火星
# 福建网站推广模板优化
# 租车网站推广流程
# 淮安seo优化要多少钱
# 品牌网站优化联系电话
# 学校网站建设项目
# 企业网站优化营商环境
# b站流量推广网站在哪看
# 更大
# 自动化
# 放在
# 指令集
# 所示
# 的是
# 可以看到
# 情况下
# 自定义
# 表现出
# claude
# 评测
# gpt4
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键
扎克伯格吐槽苹果Vision Pro:社交落后Meta太多,无法建设元宇宙
人工智能和神经网络有什么联系与区别?
数据显示:人工智能相关专业热度上升最快 考古、美术、生物医学工程等小众专业火了
【搞事】时隔4年 谷歌更新安卓logo 机器人头更饱满了
麦肯锡:到 2045 年左右,将有 50% 工作被 AI 接管
如何提高集群协作效率?中外团队合作研发基于均值偏移的机器人队形控制策略
Midjourney 5.2震撼发布!原画生成3D场景,无限缩放无垠宇宙
IBM和NASA合作发布可追踪碳排放的开源AI基础模型
“黑科技”亮相大湾区轨交论坛 智慧交通迈向“强AI”
2025年贵州省青少年机器人竞赛在安举行
零数科技CTO兰春嘉:区块链与人工智能的结合点在数据
多家欧洲企业签署公开信,批评欧盟 AI 法案草案限制产业发展
OpenAI宣布组建新团队 以控制“超级智能”人工智能
国家发改委组织工业机器人产业高质量发展现场会
中国移动主导创立元宇宙产业联盟,包括科大讯飞、芒果TV等在内,共24家成员
MIT开发“PhotoGuard”技术保护图像免遭恶意AI编辑
天翼云在国际AI顶会大模型挑战赛中获得冠军
对话式论文阅读工具PaperMate上线,综述细节AI告诉你
组建团队,字节跳动要造机器人?
对话无界AI创始人长铗:AI的创业机会在应用层丨创新者Innovator
AI无法对传统文化符号进行解构和创新
张朝阳与陆川谈AI:ChatGPT是鹦鹉学舌思维,不可能取代人类 | 把脉AI大模型
深企派遣无人机救援队赴京津冀开展防汛救灾任务
AI与5G的强强联合:唤醒数字时代的无尽潜能
科普:什么是AI大模型
衡水市冀州中学机器人社团在世界机器人大赛中斩获佳绩
软通动力多项AI创新产品及应用亮相2025世界人工智能大会
原小米 9 号员工李明打造全球首款 AI 安卓桌面机器人
苹果在韩举办首届中小企业智能制造论坛,加速推动工业4.0发展
“上海市民营企业人工智能赋能创新中心”揭牌成立
如布科技发布新产品AI口袋学习机S12
创新科学家成功研发FAST激光靶标维护机器人
SnapFusion技术大幅提升AI图像生成速度
OpenAI CEO 阿尔特曼到访日本,对全球 AI 协调合作表示乐观
华为盘古AI模型实现秒级全球气象预报时间缩短
人工智能大胆预测:银河系至少有2万个地球,36种外星文明
跑不动的元宇宙,虚拟世界比现实更冷酷
人工智能和你聊天 成本有多高
Vision Pro 太贵,苹果基于 iPhone 的 VR 头显专利曝光
人工智能产业协同创新中心:全产业链资源在这里汇聚
美图吴欣鸿:希望更多人用上AI时代的影像生产力工具
25个AI智能体源码现已公开,灵感来自斯坦福的「虚拟小镇」和《西部世界》
有远见!华为四年前注册商标Vision Pro:苹果AR国内要改名
ChatGPT只讲这25个笑话!实验上千次有90%重复,网友:幽默是人类最后的尊严
鉴智机器人发布基于地平线征程5的标准视觉感知产品
世界水下机器人大赛:9国青年携手逐梦深蓝
人工智能行业急缺人 AI人才年薪能达近42万元
探索人工智能和物联网的动态融合
无人机巡检方案是什么,该如何选择适合的巡检方案
2024-05-10

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。
